Сириус × Альфа-Банк: от отбора к MLSecOps
3-е место из 110 участников на отборе, программа MLSecOps и переход от атак на модели к защите их жизненного цикла.
Отбор: безопасность ML-моделей
В марте 2026 года я прошёл отборочный кейс-чемпионат на программу «Безопасность технологий ИИ: от разработки до эксплуатации» Сириус × Альфа-Банк. На учебном стенде были четыре задачи с разными условиями доступа к модели и разными метриками.
Часть задач давала только ответы API, другая — веса модели. От этого зависел выбор метода: в чёрном ящике приходится получать сигнал запросами, а при доступе к весам можно искать аномалии непосредственно в структуре сети.
| Задача | Что было доступно | Что требовалось проверить |
|---|---|---|
| Adversarial attack | Ответы классификатора | Можно ли направить предсказание в заданный класс |
| Обнаружение adversarial patch | Изображения с внедрённой областью | Где находится патч и насколько точна его бинарная маска |
| Model extraction | Скоринговый API и тестовые признаки | Совпадают ли подготовленные ответы с ответами исходной модели |
| Backdoor detection | Веса PyTorch-модели | Какой класс активирует триггер и какие пиксели его образуют |
Чёрный ящик: проверять на целевой модели
В adversarial-задаче сначала пробовал перенос атаки с локальных моделей. Высокая локальная успешность не повторилась на целевом API. После этого перешёл к поиску по ответам сервиса: NES и Square Attack используют оценку целевого класса, чтобы выбирать следующий кандидат.
В одном из прогонов исходные изображения не удалось получить через API, поэтому часть поиска шла от нейтрального серого входа. В этом эксперименте проверялось управление результатом классификатора; сходство с исходной фотографией по нему оценить нельзя.
В задаче локализации патча проверял GradCAM, чувствительность к перекрытию областей и поиск квадратной маски. Перебор положения и размера области оказался полезнее, чем попытка перенести объяснение от локальной модели на неизвестную целевую. Качество сравнивал по IoU — пересечению найденной маски с правильной относительно их объединения.
Model extraction: сначала прочитать контракт метрики
В задаче кредитного скоринга дали 500 тестовых строк с 12 признаками. Fidelity считалась как доля совпадений с ответами исходной модели именно на этих строках. API позволял запросить каждую из них, поэтому я использовал query-and-copy: получил ответы и собрал их в требуемый формат.
Результат — fidelity 1.0 на выданном тестовом наборе. Здесь не обучалась универсальная копия скоринговой модели. Сильный результат получился из-за доступности оцениваемых входов и устройства проверки; качество обобщения на других данных этим экспериментом не измерялось.
Для проектирования защиты это полезный пример: метрику, доступ к оценочным данным и бюджет запросов нужно рассматривать вместе. Иначе формально хороший результат может отвечать на более узкий вопрос, чем предполагает название задачи.
Backdoor detection: от оптимизации маски к анализу весов
Для последней задачи предоставили полносвязную MNIST-модель: 784 входа, скрытые слои 512 → 256 → 128 и 10 выходных классов. Нужно было найти целевой класс бэкдора и бинарную маску триггера размером 28×28.
Сначала применил Neural Cleanse: поиск малого триггера для каждого выходного класса. Целевой класс нашёлся, но восстановленная мягкая маска получалась размытой. Поэтому я проверил веса напрямую:
- В выходном слое у класса 6 норма весов была заметно выше остальных: около 14.1 против примерно 3.0.
- В первом слое выделялись 25 входных пикселей с существенно большими абсолютными весами.
- После раскладки этих пикселей в сетку 28×28 получился квадрат 5×5 в центре. Его использовал как бинарную маску триггера.
Эта проверка дала IoU 1.0 в отборочной задаче. Метод опирался на выраженную аномалию конкретной учебной сети; его применимость к другим архитектурам требует отдельной проверки.
Результат отбора
| Показатель | Результат в отборочном кейсе |
|---|---|
| Место | 3-е из 110 участников |
| Model extraction fidelity | 1.0 |
| Backdoor detection IoU | 1.0 |
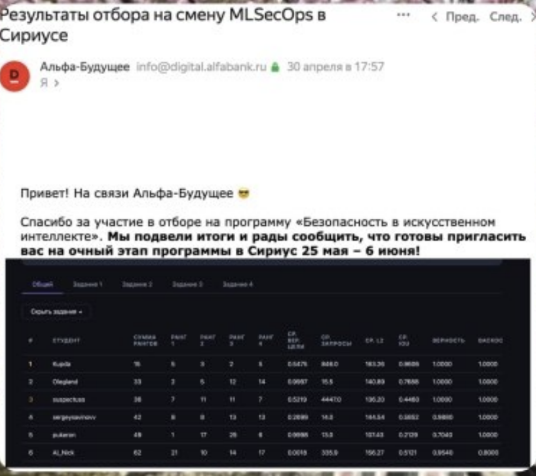
Fidelity и IoU относятся к двум отдельным задачам отбора. Они не являются общей оценкой защищённости моделей или эффективностью платформы Argus.
Программа: MLSecOps от разработки до эксплуатации
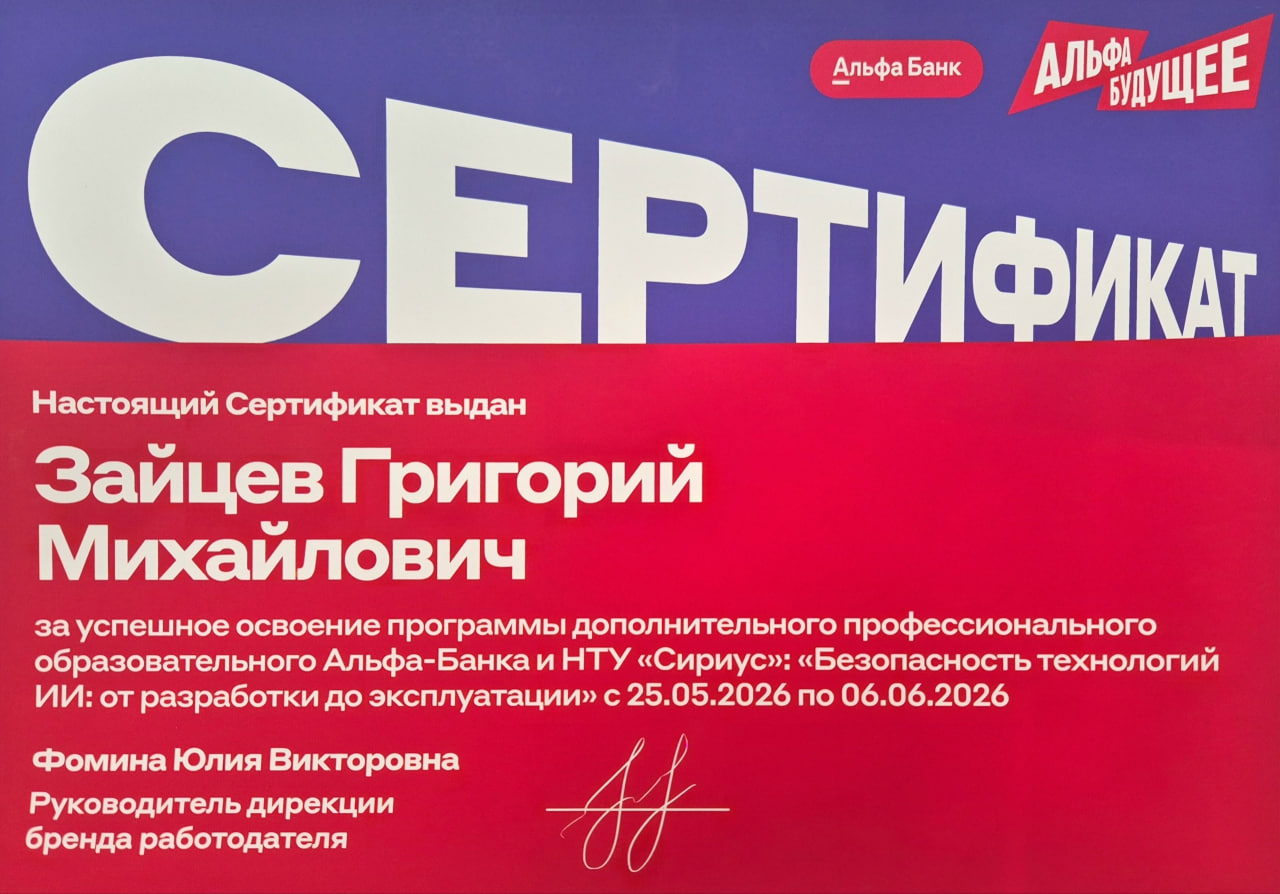
После отбора я прошёл ДПО в Сириусе с 25 мая по 6 июня 2026 года. Программа охватывала MLSecOps, adversarial ML, безопасность цепочки поставок моделей, угрозы LLM и конфиденциальное машинное обучение.
Первая неделя была интенсивной: по пять пар в день, атаки на модели и способы защиты, разбор утечек данных, запрещённых инструкций и отравления. Угрозы рассматривали на каждом этапе — от подготовки данных до эксплуатации модели. Обсуждали подходы ФСТЭК и MITRE, инструменты и архитектурные решения на примерах из банковской практики.
После отбора фокус расширился до жизненного цикла модели. Угроза может находиться во входных данных, обучающей выборке, коде подготовки, зависимостях или самом артефакте. У каждой проверки должны быть понятные входы, владелец результата и действие при обнаружении проблемы.
Поэтому MLSecOps для меня связывает техническую проверку с процессом: какая версия проверена, из каких данных она получена, кто может её выпустить и что происходит после обнаружения риска в эксплуатации.
Командный проект: Sirius Argus
На программе мы перешли от отдельных атак к защите всего жизненного цикла модели. Это стало основой командного проекта Sirius Argus: платформы с реестром моделей, проверками артефактов, разграничением доступа и контролем выпуска.
К командным кейсам перешли на второй неделе. С 1 июня работали над архитектурой и защитой Argus; предзащиты прошли 3 и 5 июня, финальная защита — 6 июня. Мой вклад был связан с архитектурным предложением, моделью доступа и подготовкой презентации.
В отдельной статье об Argus показаны экраны проекта и объяснено, как реестр, проверки, ручное одобрение и аудит соединяются в один процесс.
Сертификат программы · Достижения
Материалы: программа в ГУАП · фотоальбом Киберполигона ГУАП.